
はじめに
こんにちは、二次元コンテンツ開発部でECサービスのフロントエンドを担当している皆川(@yu_kgr)です。
私がこのサービスに関わりはじめた頃は、画面表示に関わるファイルを一つ直すだけでも、影響範囲を調べるのに時間がかかっていました。さらに、ホットリロードがなかったため、画面を確認するには、修正のたびにビルドしてローカル開発環境へ配置する必要がありました。フロントエンド向けの静的解析やテストも、十分には整っていませんでした。
この記事では、プロダクトの開発・運用を止めずにフロントエンドを改善するため、何を測り、どの単位で進め、領域ごとにどのような安全網を置いてきたのかを紹介します。取り組みは今も進行中で、すべてがきれいに片付いた「成功談」ではありません。
これまでの取り組みの一部は、以下の記事で紹介しています。
技術の具体的な移行手順は関連記事に譲り、ここでは見積もりや着手順の前提をどう見直し、調査や実績をその後の計画へどう反映してきたのかを振り返ります。
改善を始めるまで
出発点 — 技術の古さより、混在がつらかった
このサービスでは、バックエンドとフロントエンドのエンジニアが同じチームで開発しています。
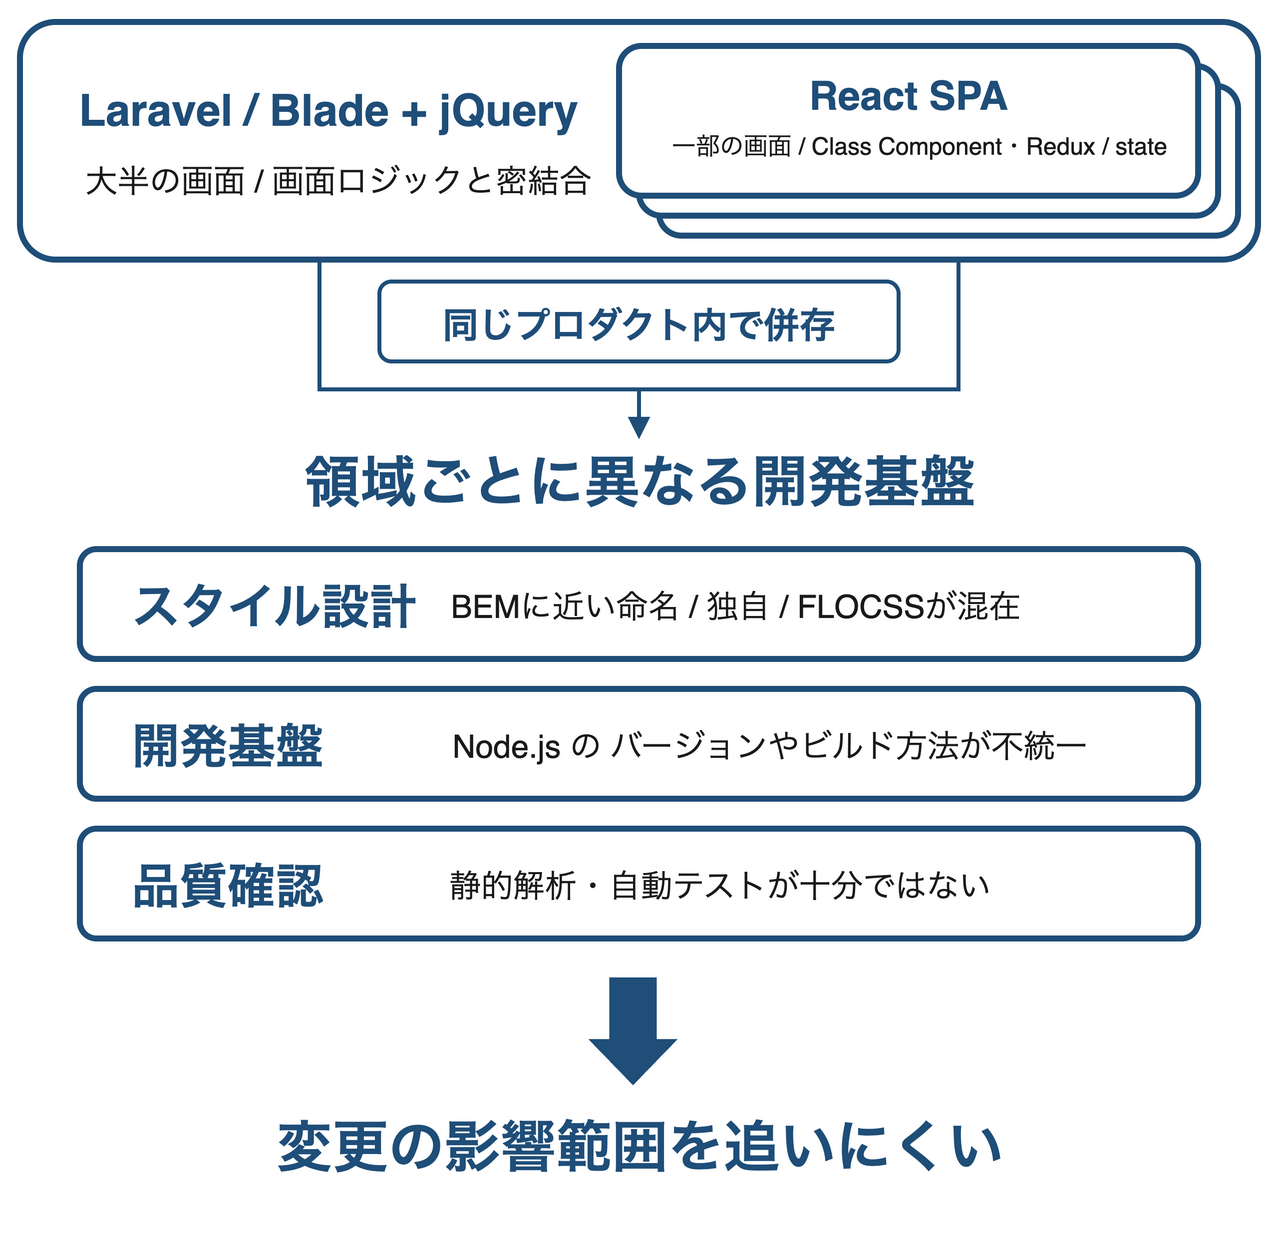
私が関わりはじめた頃、画面には大きく二つの実装形態がありました。一部はSingle Page Application(以下、SPA)として実装され、大半はLaravelのBladeテンプレートを基盤としていました。SPAの中心となっていたのは、ReactのClass Componentです。
同じReactを使った画面でも、Reduxで状態を管理する画面と、Class Componentのstateを中心に管理する画面が併存していました。どちらかが誤りというより、長期運用の中で異なる実装方針が残っていました。
Blade側では、BladeテンプレートとJavaScriptが密に結びついていました。
Blade側のJavaScriptは主にjQueryで実装され、当時のバージョンは1.8.3でした。その後、バージョンの更新は完了しましたが、jQueryへの依存自体は今も残っています。
つらかったのは、どれか一つの技術が古いことではなく、Reactで作られたSPAと、jQueryに依存する実装が同じプロダクトに混在していたことです。 例えば、購入済み作品の閲覧機能で私が確認した範囲では、Reactが描画した要素に対してjQueryの処理を行い、MutationObserverを使ってさらに要素を更新する実装もありました。
また、スタイルにはBEMに近い命名、独自の命名、FLOCSSに沿った命名が混在していました。Node.jsのバージョンやビルド方法も、領域ごとに揃っていませんでした。そのため、ファイルを開いてコードを読むだけでは、画面の表示を決めている箇所や、変更が波及する範囲を把握しにくいうえ、静的解析やテストも十分に整っていませんでした。
さらに、スタイルやスクリプトを直すたびにビルドし、生成物を開発環境へ配置する必要があり、2023年8月の単発計測では全体ビルドに3分前後かかっていました。つまり、スタイルを1行だけ直した場合でも、画面を確認するまで同程度待つ状況でした。
ここまでの経緯を、私自身がすべて把握しているわけではありません。バックエンドの段階的なリプレイスが先に進んだ時期もあり、その取り組みは「サーバーサイドのレガシーシステムを、ビッグバンではなく堅実にリプレイスした話」で紹介されています。ただし、この記事で扱われているのはサーバーサイドで、フロントエンドの改善は範囲外でした。
これは、誰かの判断が間違っていたという話ではありません。その時々の優先順位によって、フロントエンドには異なる時期や方針で作られた実装が残りました。個別の不具合に対応するだけでは、別の箇所を変更するたびに同じような難しさに直面します。そこで私たちは、フロントエンドに関する対応を一つの改善活動としてまとめ、土台から順に進めることにしました。
フロントエンドの全面リプレイスではなく、段階的な改善を選んだ
最初に考えたのは、LaravelのViewを含む既存の画面実装をフロントエンド側へ移し、LaravelはAPIを提供する役割に寄せることでした。例えば、Next.jsのようなフレームワークで画面を描画する構成は、当時の私にとって理想形の一つでした。
もちろん、一気に差し替えるのが簡単だと思っていたわけではありません。それでも、既存コードを長い時間かけて少しずつ直すより、進め方そのものはシンプルに見えたため、できることならすべて作り直したいと考えていました。
今回の改善活動は、フロントエンドエンジニアが主体となったボトムアップの取り組みです。当時、フロントエンドを主に担当するメンバーは限られ、バックエンドエンジニアもBladeやSPAを変更していました。そのため、フロントエンド全体の技術スタックを変えるには、バックエンドやインフラとの連携だけでなく、チーム全体の学習や開発フローの移行も考える必要がありました。
また、チームは、SPAやBladeに組み込まれたJavaScriptを含むフロントエンド実装の全体像を把握していたわけではありません。当時の私たちには、Next.jsを本格的に扱った経験もありませんでした。
当時は、移行単位や新旧基盤の並行運用、既存開発への追従方法まで具体化できておらず、全面リプレイスを進めるうえでの不確実性が大きいままでした。そのため、まずは既存の運用を続けながら、小さな単位で改善を進める方針を選びました。
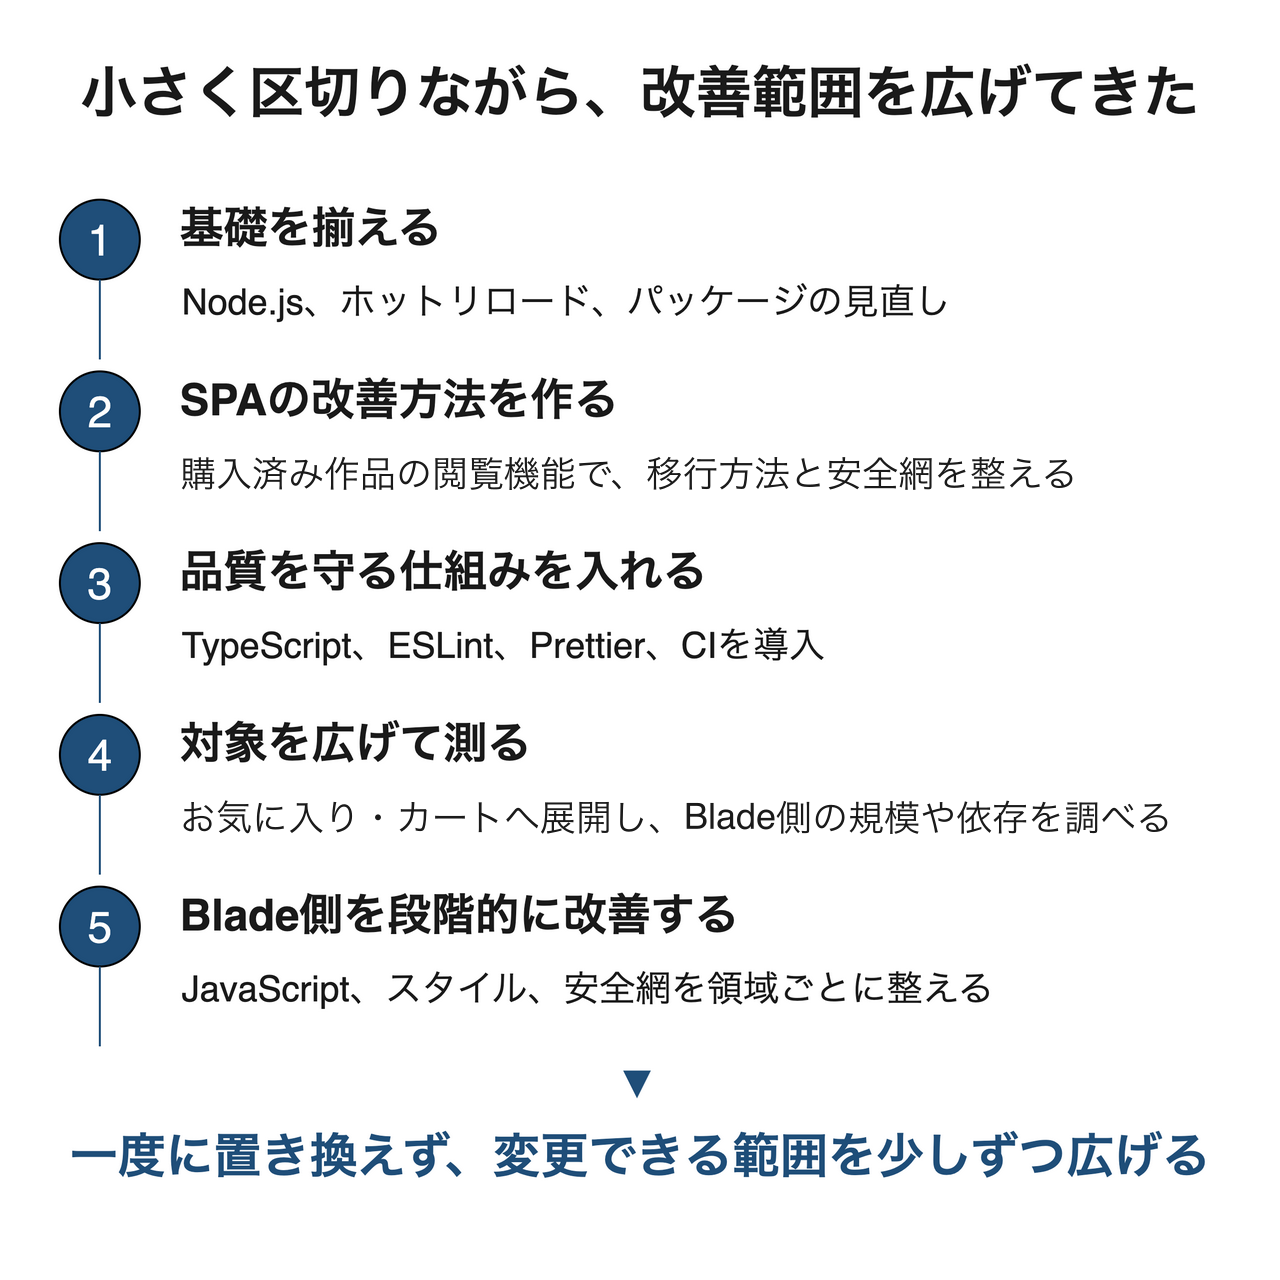
この方針のもと、基礎を揃え、購入済み作品の閲覧機能でSPAの改善方法を作り、お気に入りやカートへ対象を広げました。現在はBlade側の改善を段階的に進めています。
どこから着手するかを比較し、SPAから始めた
段階的に進めると決めた後、次に考えたのは、どこから着手するかです。技術的負債を解消する範囲とフェーズ順をチームで比較し、最初の対象には購入済み作品の閲覧機能を担うSPAを選びました。直近までチームで開発しており、構造をもっともよく理解していたためです。
チームは、Node.jsのバージョンを揃えてホットリロードの環境を整え、Class Componentを関数コンポーネントへ移し、JavaScriptをTypeScriptへ移行しました。対象領域への理解があったことで、これらをどの順番で進めるかまで具体化できました。
その後、私たちはここで得た進め方を、お気に入りやカートといった小さめのSPAへ展開しました。ただし、SPAとLaravel / Blade側では規模や画面とJavaScriptの結びつきが異なり、同じ方法をそのまま適用できないことは、ある程度想定していました。
当時は、進め方を具体化しやすいことを優先しました。一方で、Blade側は日常的な機能改修が多く、改善できれば、その後の開発でも効果を得やすい領域でした。この順序が最適だったかは、今も判断できていません。ただ、この経験以降は、技術的な進めやすさだけでなく、変更頻度やプロダクト・チームへの効果も、着手順を決める材料にしています。
改善中に前提を見直した二つのケース
ここからは、改善を進める中で前提を見直した二つのケースを紹介します。一つは領域ごとの確認方法、もう一つは作業の見積もり方です。
ケース1:領域ごとに安全網を変えた
SPAとBlade側の違いは、改修中に置く安全網にもっともはっきり表れました。
はじめに、この記事でいう安全網の範囲を整理します。
プロダクト全体には、主要な機能を一連の流れで確認するゴールデンルートテストやリグレッションテストがあり、私たちはこれらを品質保証(QA)チームと連携して別途保守しています。ここからは、フロントエンド改善プロジェクトで改修中の確認に使った仕組みを扱います。
最初のSPAでは、テストを残すつもりで作っていなかった
購入済み作品の閲覧機能をClass Componentから関数コンポーネントへ移行する作業中に、ロールバックが必要となる不具合が発生しました。
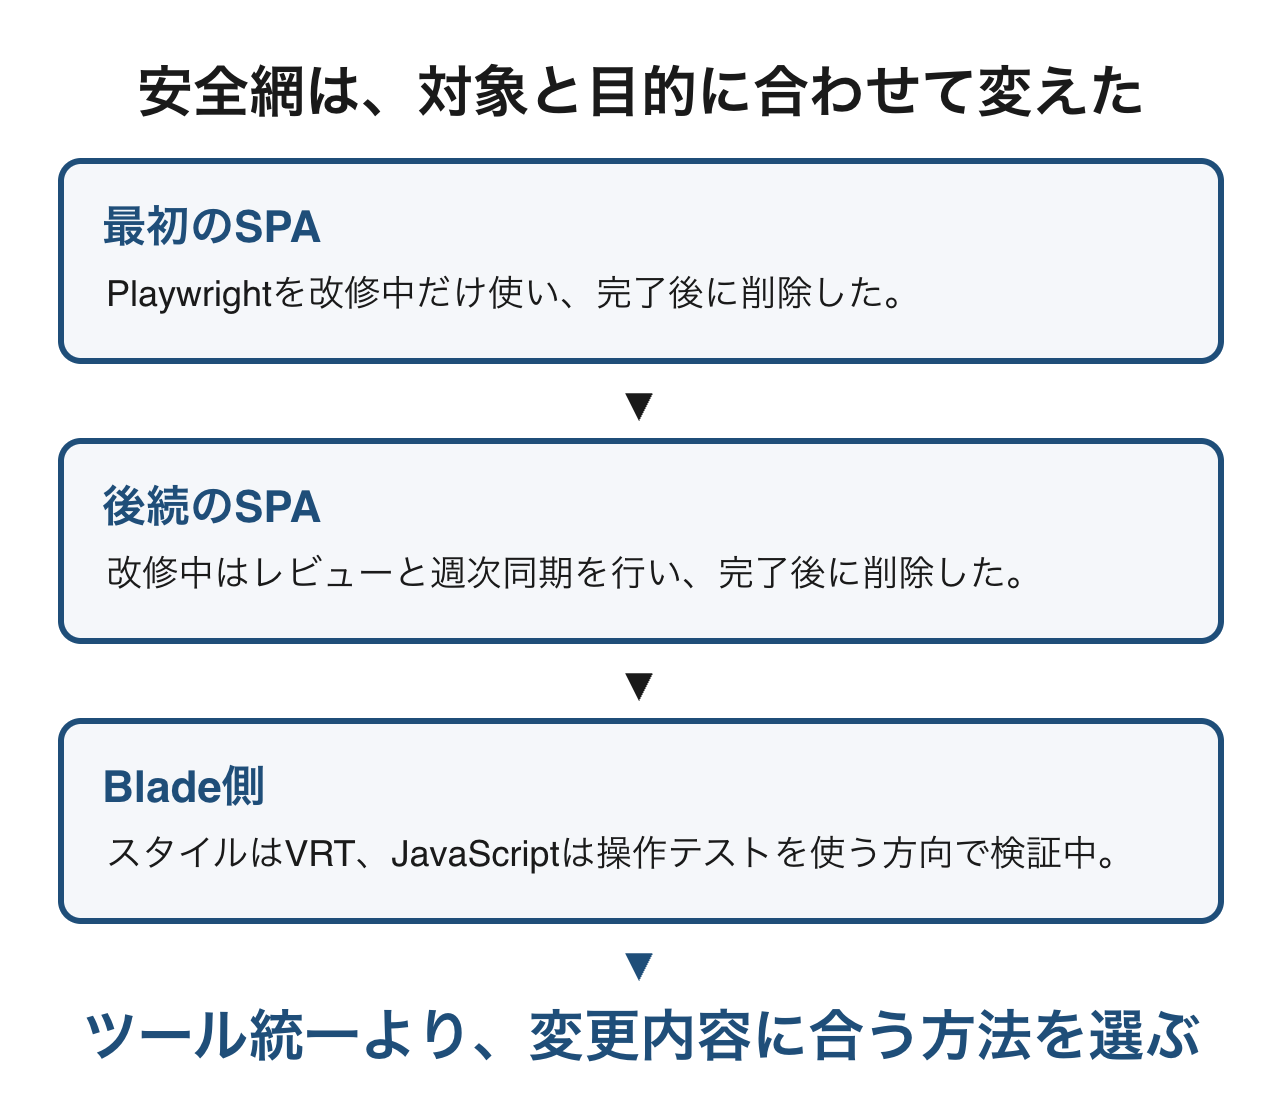
この不具合を受け、実装を変える間もユーザーから見える振る舞いに変化がないことを確認する必要があると考えました。チームで複数のEnd-to-End(以下、E2E)テストツールを比較した結果、リファクタリング中にローカルで使う一時的な確認手段として採用したのがPlaywrightです。
テスト自体は改修後に残さない前提でしたが、選定理由やテストケースの作り方、実行方法は、チーム内で再利用できるよう文書に残しました。
用意したテストは、Class Componentからの移行に加え、後に行った状態管理の移行でも利用しました。内部の実装を変えながら、主要な操作に変化がないことを確かめるためです。
当初の目的は改修中の振る舞いを確認することだけで、継続運用のための保守方法までは設計していませんでした。そのため、一連の改修が終わった時点で、このテストを削除しました。
同じPlaywrightでも、改修中の運用を変えた
その後、お気に入りやカートを改善する際も、先にPlaywrightのテストを用意しました。ただし、最初のSPAとは異なり、改修期間中はテスト用リポジトリの変更をPull Requestでレビューし、対象コードの変更を週次で取り込むルールを設けました。
後続のSPAでも、Playwrightは改修中の確認手段として使い、改修完了後に削除しました。最初のSPAとの違いは、テストを継続して残したことではなく、利用期間中のレビューと同期方法を決めたことです。
Blade側には、そのまま持ち込めなかった
Blade側では複数の改修が並行し、画面の状態やデータも頻繁に変わります。そのため、フロントエンド改善用の操作テストを安定して実行するには、同じ状態を再現する段階から負担がかかります。
そこで、Blade側のスタイル改修には、Visual Regression Test(視覚的回帰テスト、以下、VRT)を使う方針にしました。別の改善活動では、スクリーンショットを比較するLost PixelとPlaywrightを組み合わせたVRT基盤を整備し、検証環境での動作確認まで終えています。フロントエンド改善プロジェクトへの適用はこれからです。
開発チームでは、これとは別にBladeコンポーネント単位のVRTも構築し、検証を進めています。
ただし、VRTだけですべての改修を確認できるわけではありません。JavaScriptのリファクタリングでは、画面操作による確認も必要になるため、スクリーンショットの比較に加えて、Playwrightによる操作テストも必要だと考えています。変化の多いBlade側で、どこまでを安定してテストできるようにするかは、現在も検証中です。
もう一つ、作業を進める中で見直したのが、見積もりの方法です。
ケース2:コードを直す時間しか見積もっていなかった
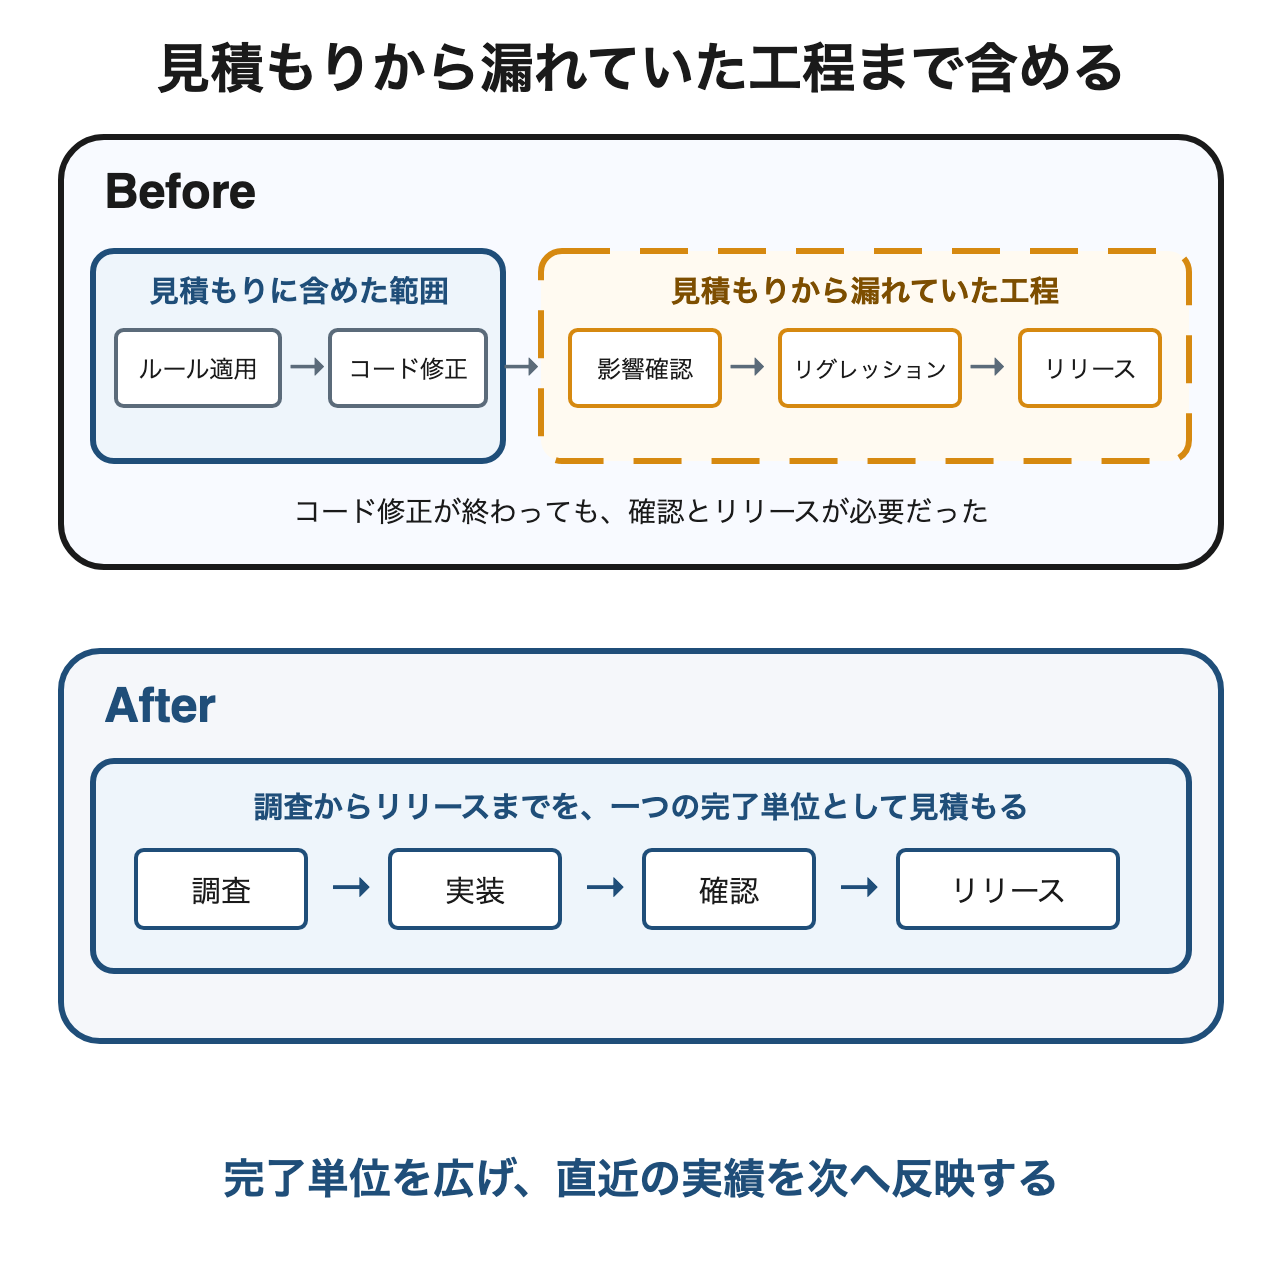
想定と実際の差が特に大きかったのは、ESLintとPrettierのルールを整備したときです。当初は、コードの変更を細かく分け、対象のルールを一つずつ適用してエラーを直せば進められると考えていました。
ところが実際には、ルールを適用するたびに影響範囲を確認し、リグレッションテストを行ったうえで、安全にリリースする必要がありました。コードを直す時間だけでなく、確認とリリースにも相応の時間がかかります。
コードの修正は細かく分けられても、確認とリリースを繰り返せる回数には限界があります。私たちはこの工数を十分に見積もれておらず、計画どおりに進みませんでした。実装工数だけを中心に考えていたため、見通しが甘かったと振り返っています。
そこで短期的には、一部のルールを無効化し、後のフェーズで再び有効にすることにしました。優先したのは、すべてのルールを一度に適用することではなく、新たな違反を増やさないことです。ただし、再有効化する時期まで決めなければ、積み残しは次のフェーズへ移ります。
この経験から、調査、実装、確認、リリースのすべてを見積もりに含めるようにしました。全体計画は暫定的に立て、直近の実績から分かる範囲をその都度共有しています。
前提となる情報が足りない場合は、無理に数字を出さず、まず調査を別のタスクとして切り出します。また、見積もり時に確認する観点をチームで揃え、必要な工数だけでなく、リスクや依存関係も確認します。
測りながら進め方を整えた
どこから直すかを決めるために測った
見積もりや着手順の前提を揃えるために行ったのが、JavaScriptとスタイル(SCSS)の定量調査です。
それまでも「複雑で触りにくい」という感覚はありましたが、着手箇所をチームで決める根拠としては不十分でした。そこで、ファイルの規模、依存関係、グローバル変数、循環的複雑度(コードに含まれる分岐の多さを数値化した指標)、インラインスタイルの分布を調べました。
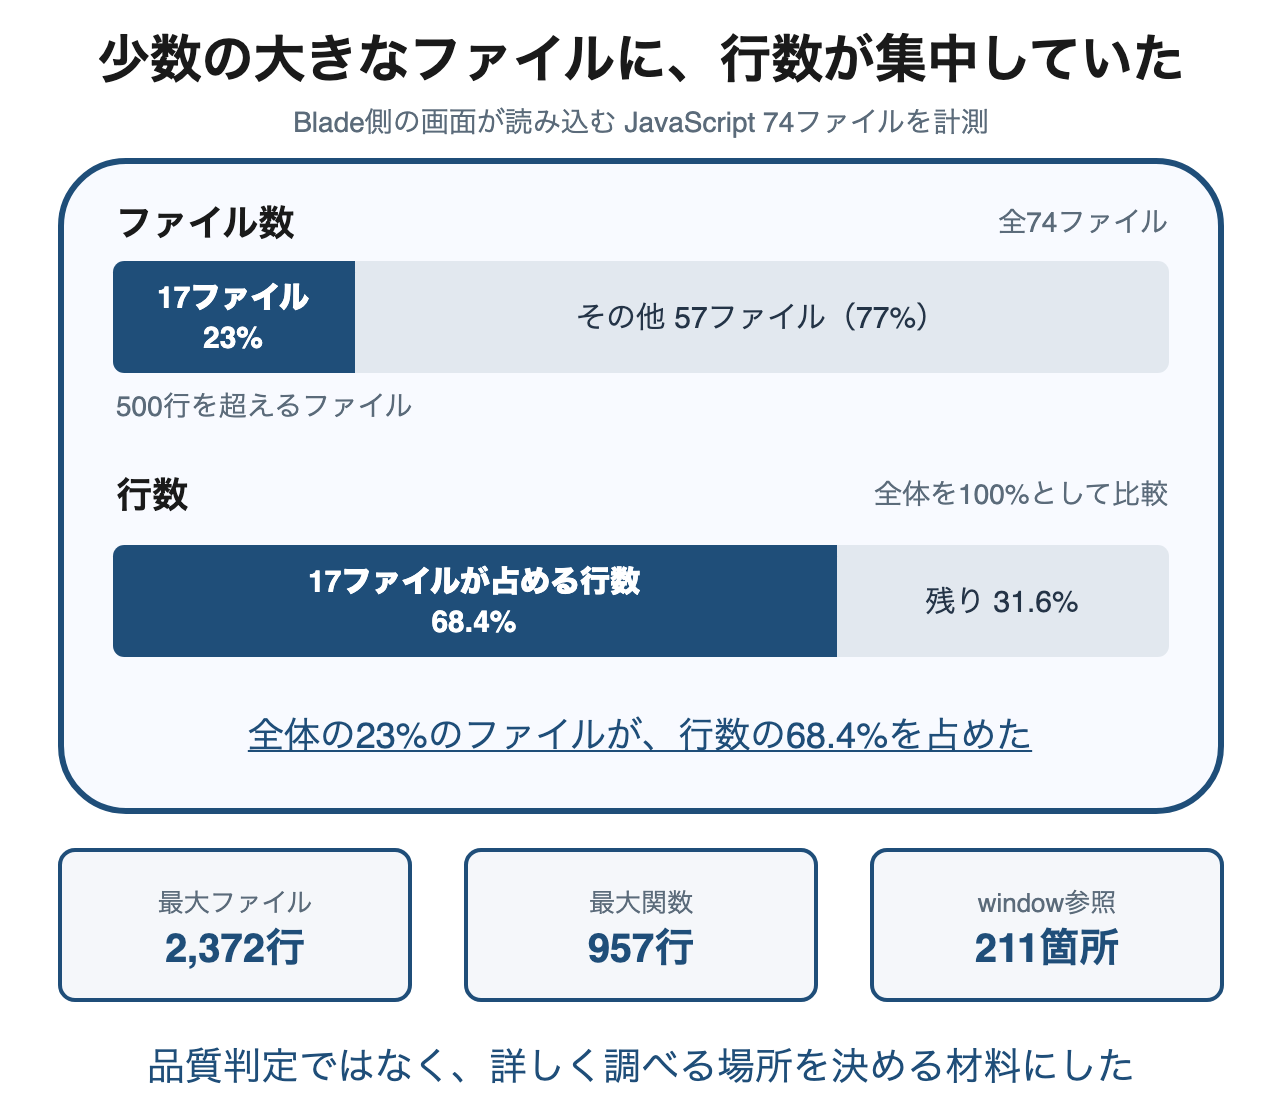
2026年2月末に、着手前のBlade側で画面が読み込む74個のJavaScriptファイルを計測したところ、500行を超える17ファイルだけで全体の行数の68.4%を占めていました。最大のファイルは2,372行、最大の関数は957行で、ブラウザのグローバルオブジェクトである window への参照も211箇所ありました。
行数だけでコードの良し悪しは判断できません。今回の計測から、規模や依存が一部のファイルに集中していると分かり、この結果をもとに詳しく調べる箇所をチームで決めました。
また、2024年6月に領域別で調べた範囲では、SPA側とBlade側の平均循環的複雑度に2倍以上の差があり、プロダクト全体を一律の順番や安全網で進めず、領域ごとに方法を変える判断材料にもなりました。
後のフェーズでは、チームが循環的複雑度の検査を継続的インテグレーション(以下、CI)に組み込みました。先に紹介したCIの記事では、その記事が対象とした範囲で、閾値10を超える違反が52箇所見つかったと報告されています。
ただし、この52箇所は、実装前に行った調査とは時期・対象・目的が異なり、直接比較できません。
私が担当したのは、進め方を整えること
ここまで「私たち」と書いてきたとおり、この活動は私一人で進めたものではありません。
技術的な意思決定は、実装を担当するメンバーを中心にチームで行っています。私の役割は、フロントエンド改善の方向性と期待する効果について認識を揃え、選んだ手段がその目的から外れていないかを確認することです。
そのために、方針の文書化、タスクの分解、優先順位の調整、週次での進捗の可視化を行っています。進行に遅れが出た場合は、それまで見えていなかった要因を確認し、必要に応じて計画や見積もりを更新します。
日々の案件と改善活動の優先順位がぶつかったり、突発対応で予定が崩れたりすることもあり、計画どおりに進む週ばかりではありません。この活動の進捗は週次で上長へ報告しており、計画との差が生じた場合には、その要因を説明します。
一方で、調査によって当初の計画にはなかった作業が判明することもあります。こうした作業を単純な遅延として扱うべきかは、私自身も迷うところです。そこで、新たに分かった作業を計画へ反映し、その時点で見えている情報をもとに見積もりを更新しています。
技術的な判断そのものを一人で決めるのではなく、判断材料と進め方を整えながら、改善活動全体の方向性、優先順位、進行に責任を持っています。
ここまでの変化と次の判断
ここまでに積み重ねてきたこと
ここで、これまでに進めてきた技術的な施策を短く整理します。
- 基礎を揃える:Node.jsのバージョン統一、ホットリロード環境の整備、パッケージの見直し
- SPAの改善方法を作る:Class Componentから関数コンポーネントへ移行し、Playwrightによる改修中のE2Eテストを導入
- 品質を守る仕組みを入れる:TypeScript、ESLint、Prettierを導入し、CIによる静的解析を整備
- 対象を広げる:お気に入りやカートへ改善方法を展開し、状態管理も移行
- 広い領域を測る:JavaScriptとスタイルの規模、依存関係、複雑度を調査
- Blade側を段階的に改善する:JavaScriptのモジュール化、スタイル設計の整理、VRT活用の準備
この中でも、購入済み作品の閲覧機能を担うSPAでは、5万行弱のJavaScriptをTypeScriptへ移行しました。
また、CIで循環的複雑度やESLintのルール違反を検査する仕組みも、チームのメンバーが整備しました。
今、どこまで来たか
改善はまだ道半ばです。
SPAでは、TypeScriptや関数コンポーネントへの移行が進み、CI上で静的解析が動くようになりました。安全網を用意してから改修する進め方も、小さめのSPAへ展開できています。
Blade側では、JavaScriptのモジュール化とスタイル設計の整理を段階的に進めています。SPAとは規模や構造が異なるため、安全網についても同じ方法をそのまま適用するのではなく、領域に合う確認方法を検証しています。
変更後の振る舞いを確認する手段は増えてきましたが、領域によって確認できる範囲にはまだ差があります。フロントエンド全体を同じ水準で安心して変更できるところまでは到達していません。
実装が速くなっても、確認の仕組みは必要だった
ここ1年ほどで、チームでもAIコーディングツールを使う場面が増えています。実装計画の整理、リファクタリング、トラブルシューティングなど、AIを活用できる作業の範囲も広がりました。開発の進め方は、すべてのコードを人が一行ずつ書くことを前提としたものから変わりつつあります。
ただ、AIがコードを速く生成できても、その変更をそのまま受け入れられるわけではありません。チーム内の検証では、実装計画の整理からコードの作成までの流れや、UIの問題調査に効果が見られました。一方で、自動テストなどによって変更後の振る舞いを確認できない領域では、AIによる変更範囲を広げにくいことも分かりました。
全面リプレイスを考えるために、先に揃えたいもの
現在、私たちは、既存の構成を大きく変えずに進められる改善を優先しています。まずは既存の構成のままどこまで課題を解消できるかを確かめ、全面リプレイスが必要かを判断するためです。
そのため、技術的負債の削減、色や余白などの値の共通化、UI部品をデザイナーとエンジニアが共通の環境で確認できるようにする取り組みを進めています。取り組みを続けながら、既存の構成で改善できる課題と、構成自体を変えなければ解決しにくい課題を整理していきます。
これは、採用する技術や移行時期まで決めたロードマップではありません。その判断に備えて、測定や運用の実績を積みながら、選択肢を比較するための材料を増やしています。
おわりに
私たちの現場では、技術的負債を一気には解消できませんでした。
SPAで使った方法をBlade側へそのまま持ち込むことはできず、安全網の置き方も対象によって変わりました。見積もりについても、コードを変更する時間だけではなく、調査、確認、リリースまで含めて考えるようになりました。
また、着手箇所や優先順位は、対象の規模や依存関係、複雑度を測った結果をもとに決めるようになりました。
こうした経験から、最初からすべてを正確に見積もることよりも、まずステークホルダーと期待値を揃え、その時点で分かる範囲を見積もることを重視しています。実際に進めて新たな情報が分かれば、計画と見積もりを更新し、分かったことをステークホルダーへ共有します。
改善は今も続いています。どの単位なら既存の運用を止めずに安全に変更できるのか、その変更にはどの安全網が適しているのかを、実際の結果を見ながら見直しています。
こうした課題が残る一方で、改善の進め方をチームで考え、必要な仕組みを整えながら継続的に取り組める環境があります。フロントエンドだけで閉じず、バックエンドやQA、デザイナーなどと協働しながら、プロダクトを動かし続けたまま改善していく仕事に興味がある方は、ぜひ採用情報もご覧ください。
